
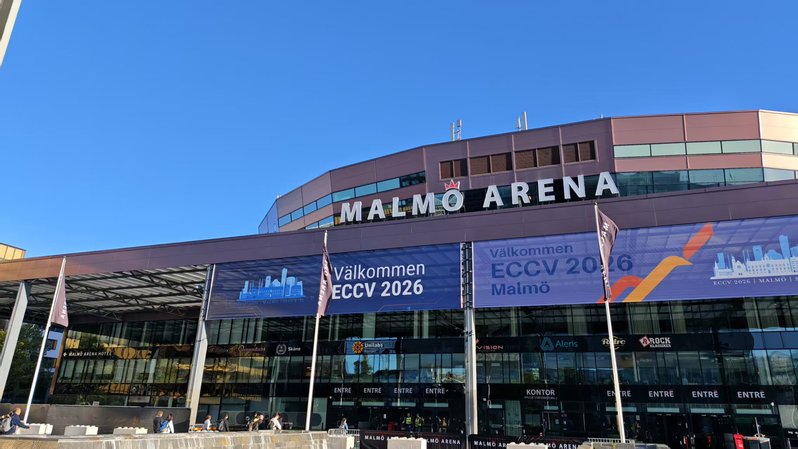
近日,实验室科研团队论文“DiGS-Avatar: Single-Image Animatable 3D Human Reconstruction via UV-Space Diffusion”被欧洲计算机视觉大会ECCV 2026录用,并以Poster形式进行展示。团队学生代表赴瑞典马尔默参加会议,在大会现场展示研究成果,并与国内外同行围绕三维人体重建、生成式模型与数字人技术等方向开展学术交流。
论文题目:DiGS-Avatar: Single-Image Animatable 3D Human Reconstruction via UV-Space Diffusion
作者:李佳坤,方力,朱昊,胡飞,叶龙,张园,颜金尧
合作单位:中国传媒大学媒介音视频教育部重点实验室、南京大学智能科学与技术学院
会议:European Conference on Computer Vision(ECCV 2026)
论文链接:arXiv:2608.20759
开源代码:DiGS-Avatar code
面向单图像可动画三维人体重建
从单张图像重建高质量、可动画的三维人体,是虚拟现实、游戏、远程呈现和三维内容创作等应用中的重要基础问题。现有方法通常面临两方面挑战:直接回归三维表示的方法虽然推理速度较快,但对人体背面及遮挡区域等不可见内容的恢复能力有限;基于扩散模型的方法则往往需要先生成多个视角,再进行三维重建,计算开销较大,并可能引入跨视角不一致问题。
针对上述问题,团队提出DiGS-Avatar,将单图像三维人体重建重新表述为规范UV空间中的二维潜变量补全问题。由于UV空间中的像素与人体表面点具有明确对应关系,该方法能够在二维生成空间中引入扩散模型的生成能力,同时保持三维空间中的几何一致性,从而兼顾重建质量、生成能力与推理效率。
教师—学生框架与几何对齐语义聚合
DiGS-Avatar采用多视图教师—单视图学生框架。训练阶段,多视图教师网络从不同视角提取并融合信息,构建几何对齐的完整UV潜变量,作为伪真值监督单视图扩散学生网络;推理阶段仅需输入一张人体图像,学生网络即可补全不可见区域对应的UV潜变量,无需在推理过程中额外生成多视图图像。
为进一步恢复服装纹理和人体外观等高频细节,论文提出Geometry-Aligned Semantic Aggregation(GASA)模块,将预训练视觉模型提取的多层语义与外观特征逐步注入几何对齐的UV表示。最终,完整UV特征被解码为3D Gaussian Splatting(3DGS)人体表示,并与SMPL-X人体模板结合,使重建结果能够直接进行姿态驱动和动画。
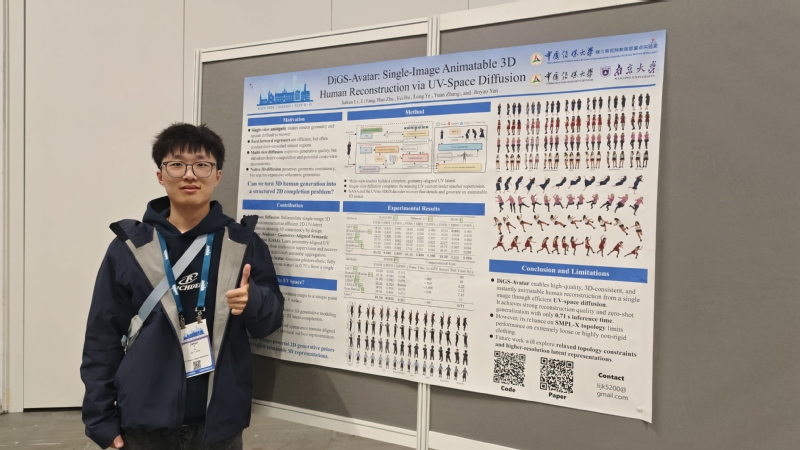
0.71秒生成可动画三维数字人
实验表明,DiGS-Avatar能够由单张图像生成具有较高视觉质量和三维一致性的可动画三维数字人。从输入图像到最终3DGS结果的完整推理时间仅约0.71秒。论文在HuGe100K、THuman 2.1和2K2K等数据集上进行了系统测试,并在SIZER以及DeepFashion和互联网图像等分布外数据上验证了零样本泛化能力。
在HuGe100K测试集上,DiGS-Avatar取得25.32 PSNR、0.940 SSIM和0.039 LPIPS; 在SIZER零样本测试中取得23.54 PSNR、0.932 SSIM和0.065 LPIPS。研究还展示了多种新姿态下的动画结果,重建得到的三维高斯基元可通过标准线性混合蒙皮直接驱动,无需额外的测试时优化。
赴瑞典马尔默参会交流
ECCV 2026会议期间,团队学生代表赴瑞典马尔默参会,并在Poster展示环节介绍DiGS-Avatar的研究思路、 方法设计与实验结果。现场围绕单图像三维人体重建、扩散生成、3D Gaussian Splatting及可动画数字人等研究方向,与参会学者进行了交流讨论。
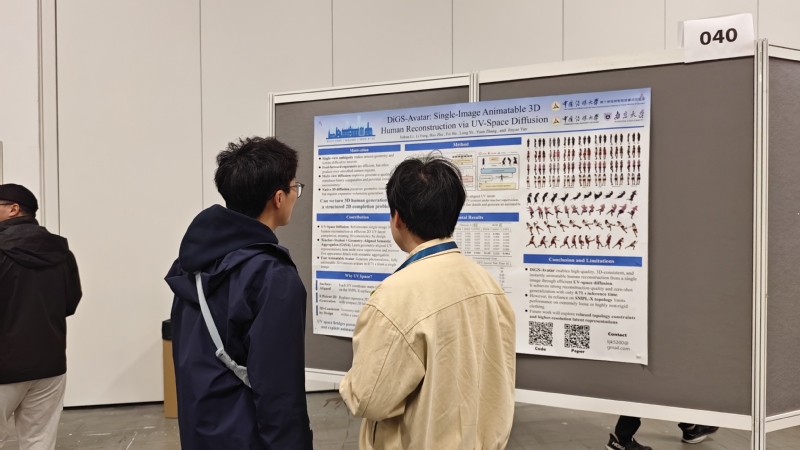
此次参会进一步展示了实验室在三维视觉与智能媒体方向的研究进展,也为团队了解计算机视觉和三维生成领域的最新研究动态、开展后续学术交流提供了机会。